Синтаксический парадокс: почему ИИ не видит того, что человек перечитывает
Человеческий мозг в процессе чтения устроен куда сложнее, чем кажется создателям языковых моделей. Исследователи из Нью-Йоркского университета и Университета Массачусетса в Амхерсте опубликовали в PNAS работу, которая вскрыла фундаментальную слабость главной метрики, используемой для оценки нейросетевых алгоритмов — так называемой вероятности следующего токена. Оказалось, что этот показатель прекрасно описывает лишь самый поверхностный, беглый этап восприятия текста, но абсолютно беспомощен, когда речь заходит о глубоком синтаксическом анализе, который человек запускает почти мгновенно.
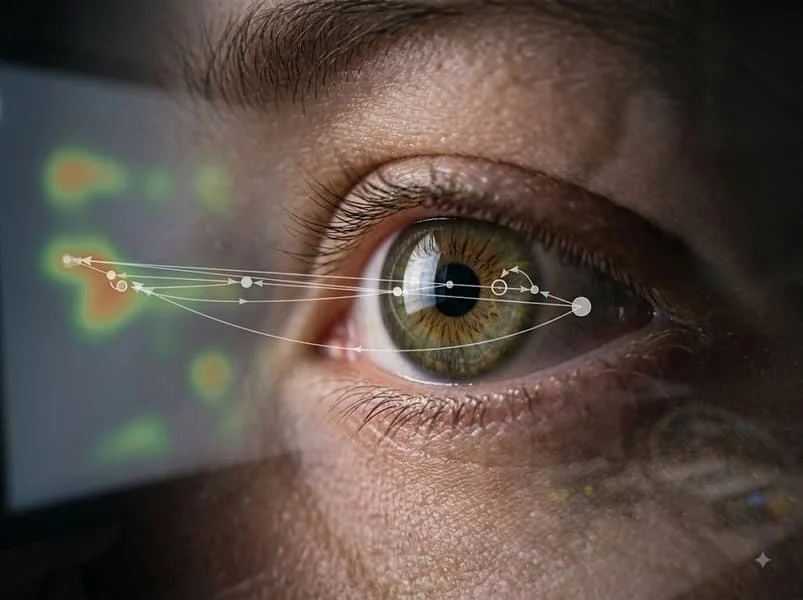
В эксперименте с участием 368 добровольцев, чьи движения глаз отслеживались с помощью айтрекинга, учёные сопоставили реальное чтение с 409 оценками «сюрпризала» — меры неожиданности каждого слова для ИИ-моделей. Участникам показывали предложения с обманчивой конструкцией, так называемыми «гарден-пат»-фразами, где грамматическая структура вначале толкает на ложный путь, а смысл проясняется только в последнем слове. Это заставляет мозг возвращаться к началу предложения и перестраивать синтаксис, что хорошо видно по движениям глаз: растёт время первого прохода, возникают регрессивные движения взгляда, увеличивается общая продолжительность повторного чтения.
Сюрпризал, который считает алгоритм, превосходно совпал с первым, быстрым проходом по словам — здесь машина и человек оказались на одной волне. Но как только требовалось пересмотреть ошибочную грамматическую интерпретацию, модель давала сбой. Она оценивает лишь линейные вероятности очередного токена, игнорируя иерархические связи между частями предложения. Другими словами, нейросеть действует как статистический автомат без обратной связи, тогда как человеческий мозг в этот момент работает как полноценный синтаксический процессор с возможностью возврата и пересборки дерева зависимостей.
Полученные данные подтверждают многостадийную теорию чтения: распознавание и первичное осмысление действительно опираются на вероятностные механизмы, но обнаружение ошибок и их исправление запускают качественно иной, более медленный и ресурсоёмкий процесс. И здесь нейросети проигрывают не просто количественно — они вообще не имеют аналогичного механизма рекурсивного пересмотра. По сути, языковая модель строит лишь приближение к тому, как человек воспринимает текст, и это приближение рушится на сложных синтаксических конструкциях.
Эта работа наносит удар по самой идее, что достаточно масштабировать вероятностные модели, чтобы достичь человеческого уровня понимания языка. Синтаксический анализ требует не просто больше данных или параметров, а иной архитектуры — такой, которая способна удерживать несколько конкурирующих грамматических интерпретаций одновременно и пересматривать их при поступлении новой информации. Пока же ИИ остаётся блестящим «поверхностным читателем», который не способен заметить, как споткнулся на сложном предложении, — и не пытается вернуться, чтобы разобраться.
Читайте также:
Почему это важно
- Белый дом готовит проверки открытых ИИ-моделей до релиза, если они…
- Корпус толщиной всего 4 см, 2304 зоны подсветки и диагональ 85…
- На станциях МЦД-2 в Москве заработала оплата проезда по биометрии
Об авторе