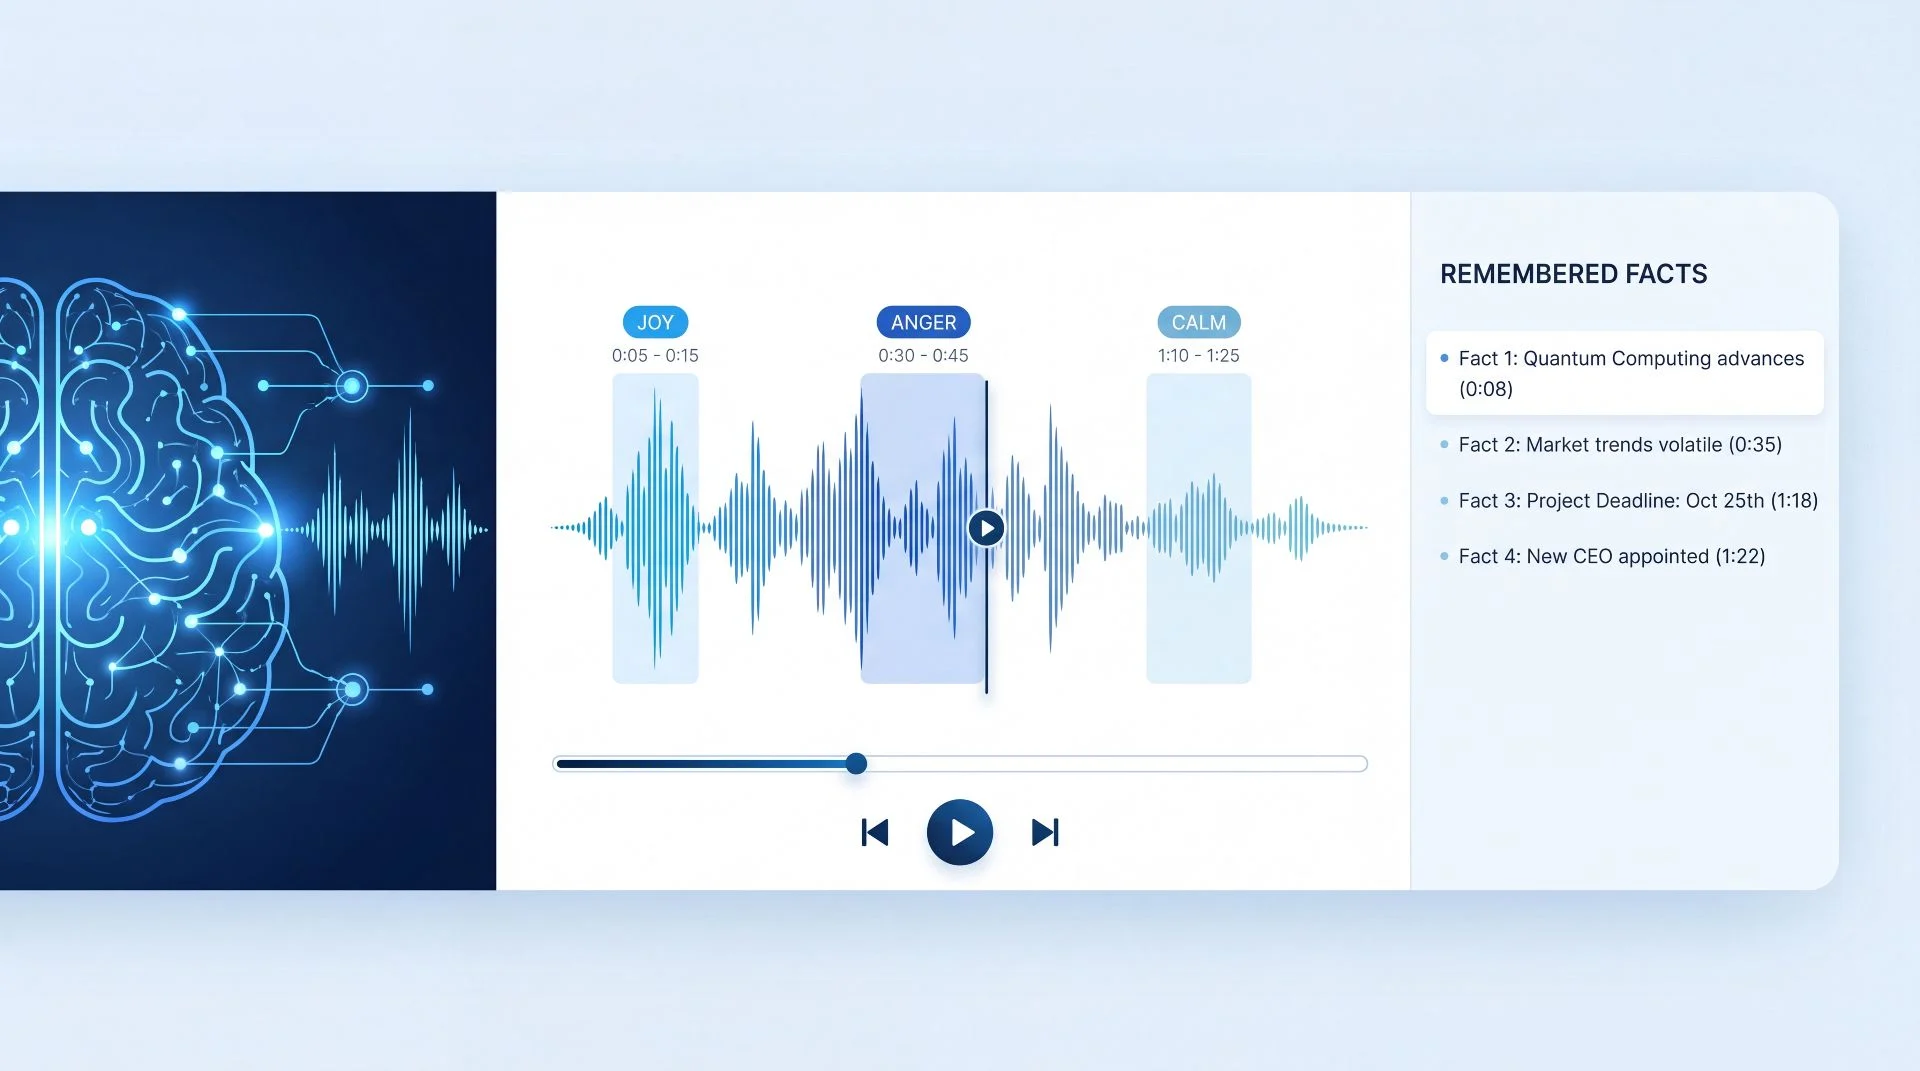
Нейросеть GigaChat Audio от Сбера анализирует интонацию и тембр, определяет эмоции с точностью 80%, обрабатывает записи до 3 часов и запоминает важные факты для будущих диалогов.
Сбер снял с ИИ наушники: новая аудиомодель не просто слушает — она слышит, запоминает и ставит диагноз голосу
Рынок голосовых ИИ наконец-то перестал быть битвой скороговорок и транскрибаторов. Сбер сделал не просто шаг, а прыжок вверх по лестнице семантического анализа: обновленный GigaChat Audio теперь не нуждается в «переводчике» с языка звука на язык текста. Он жует аудио целиком — трехчасовые совещания, лекции с шумным залом, конференц-коллы с плохой связью. Но самое интересное происходит не в моменте расшифровки, а в слое, где модель начинает щупать эмоциональную ткань говорящего.
Забудьте о сухих протоколах встреч. Нейросеть анализирует интонационную партитуру, вибрато тембра и паузы с той же дотошностью, с которой опытный HR-специалист слушает кандидата. Точность в 80% по распознаванию эмоций — это не просто цифра в пресс-релизе. Это фактически переход из категории «транскрибатор» в категорию «аналитик диалога». Особенно показательно сравнение с «тяжеловесами» вроде Kimi-Audio (62%) — разрыв в 18 процентных пунктов не оставляет сомнений, кто на этой арене играет первую скрипку на территории рунета.
Но если распознавание трендовых паттернов речи — дело техники и хорошо промороженных датасетов, то внедрение долговременной памяти ломает привычную парадигму «безликого секретаря». Модель теперь не просто обрабатывает текущий запрос, а строит кастомную модель пользователя на основе предыдущих фактов, озвученных голосом. Это, безусловно, гейм-чейнджер для персонализации. Однако Сбер, в отличие от западных гигантов, сразу вшил в архитектуру «красную кнопку» — пользователь в любой момент может залезть в настройки памяти, отредактировать сохраненные данные или уничтожить их. В эпоху тотальной слежки за контентом такой оверсайт со стороны разработчика выглядит не просто вежливостью, а стратегической необходимостью.
Бенчмарки, которые привела команда, выглядят по-настоящему вкусно. В тесте Arena Hard Audio наш «гигант мысли» обходит предшественников на 13% и дышит в затылок пресловутому Gemini-3-Flash-preview. С учетом того, что российская модель работает в гораздо более жестких условиях лингвистического многообразия (акценты, искажения), этот результат пахнет если не сенсацией, то как минимум крепкой заявкой на технологическую самодостаточность.
Но где кроется настоящая интрига? В возможности модели различать спикеров и создавать пересказы с таймкодами без лишней воды. Представьте: судебная стенограмма, трехчасовой питч-сешн или даже семейный аудиоархив. GigaChat Audio становится не просто приложением, а контекстным агрегатором информации. Он не выдает «простыню» текста, а выжимает суть, расставляя временные метки на ключевых инсайтах.
Для бизнеса это переход на новый уровень контроля качества коммуникаций: теперь можно тестировать не содержание, а то, *как* клиент произносит слова. Для образования — возможность дать не просто лекцию, а интерактивный аудиоконспект с эмоциональной разметкой сложных тем. И пусть некоторые оппоненты будут ворчать о том, что 75% побед в Arena — это «всего лишь бета», но факт остается фактом: российский ИИ снял наушники и пошел в глухое аудио без проводников. Это уже не «скоро», это уже «здесь».
Читайте также:
Почему это важно
- В России создали «нейропамять» для дронов: ИИ запоминает всё, что…
- OpenAI не сообщила властям о подозрительном диалоге с ChatGPT,…
- ИИ в космологии: машинное обучение помогло уточнить параметры…
Об авторе