Диффузионные модели: как нейросети учатся генерировать видео
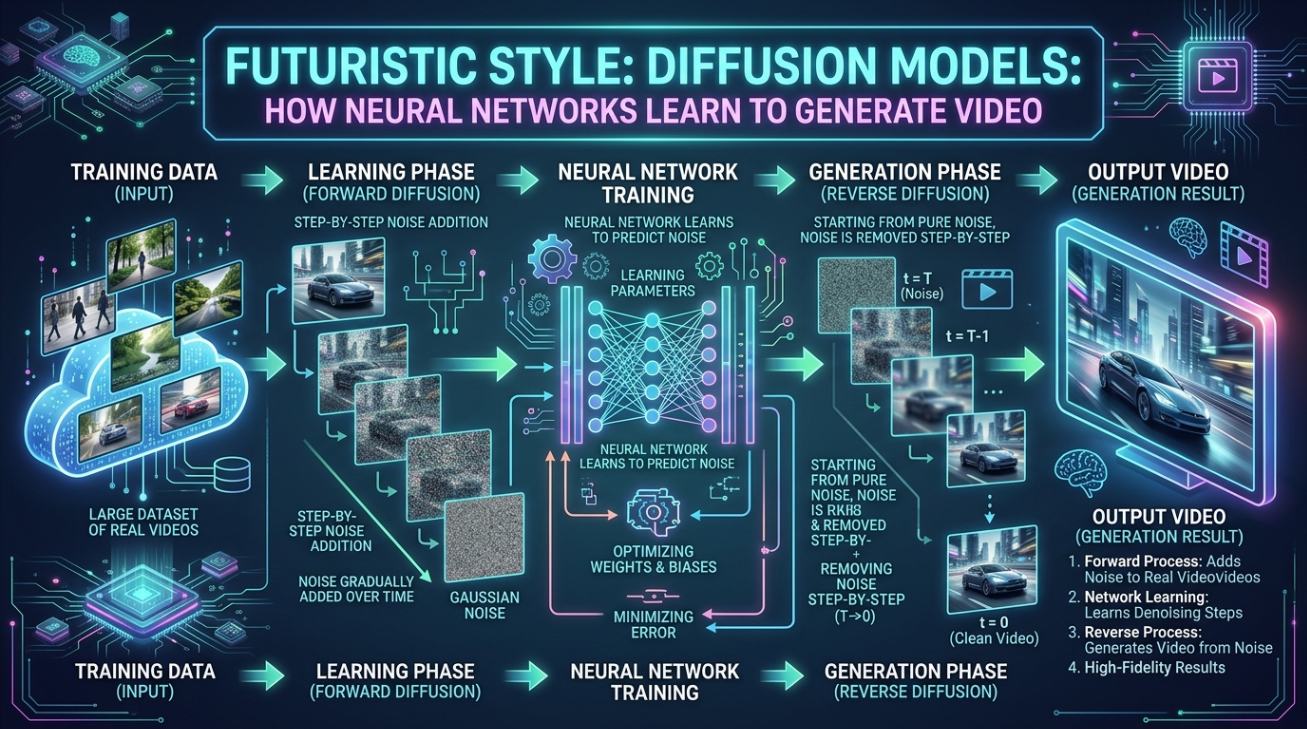
Генерация картинок по тексту уже привычна, а вот видео долго оставалось сложным — нужно держать сюжет, движение и стабильность кадра. Диффузионные модели меняют это: они учатся «проявлять» клип из шума, шаг за шагом уточняя детали, и теперь создают короткие ролики по описанию.
Как это работает
Модель стартует с случайного шума и постепенно убирает его, ориентируясь на текстовую подсказку. На каждом шаге картинка становится четче, а временные слои связывают кадры, чтобы объект не прыгал. Современные системы держат персонажа, свет и даже простую физику движения.
Где применяют
Рекламщики собирают прототипы роликов за минуты, аниматоры тестируют раскадровки, а преподаватели — наглядные демонстрации. Это соседствует с генеративным ИИ в дизайне и агентами ИИ, которые могут управлять такими инструментами автономно.
Риски
Синтетическое видео легко использовать для дезинформации, поэтому важны водяные знаки и маркировка. Технология ещё учится длинным сценам и точному тексту в кадре, но темп прогресса высок.
Диффузионные модели открывают эру текстового видео, где ролик рисует нейросеть. Читайте также о том, как генеративный ИИ уже меняет дизайн и как автономные агенты берут задачи на себя.
Читайте также:
- Генеративный ИИ в дизайне: от текстового описания к изображению
- Агенты ИИ: что это и как автономные помощники меняют работу
- ДНК-хранение: как упаковать весь интернет в грамм вещества
Об авторе

1 комментарий для “Диффузионные модели: как нейросети учатся генерировать видео”